Najlepsze modele AI · październik 2026
Ranking modeli AI 2026: Claude, Gemini czy ChatGPT?
Porównujemy wyniki rankingów, ceny i zastosowania. Wybierz AI do tekstu, analizy lub kodowania, zamiast płacić za możliwości, których nie potrzebujesz.
Ten ranking modeli AI 2026 dotyczy modeli do tekstu, analizy i pracy z narzędziami. Jeśli szukasz najlepszego AI do codziennej pracy, sama pozycja w jednej tabeli nie wystarczy. Model świetny w rozmowie może inaczej wypaść przy poprawianiu programu lub wykonywaniu zadania w przeglądarce. Dlatego zestawiamy trzy rankingi i przekładamy ich wyniki na konkretne zastosowania.
Ranking modeli AI 2026: nasza piątka do pracy
Poniższa kolejność jest oceną redakcyjną wspierani.pro. Łączy możliwości modeli, przydatność do pracy i koszty. Nie jest średnią z punktów różnych benchmarków ani wynikiem naszych własnych testów wszystkich modeli. Pełne tabele źródłowe obejmują znacznie więcej pozycji.
| Nasz wybór | AA Intelligence Index | Agent Arena: miejsce | Do czego warto sprawdzić |
|---|---|---|---|
| 1. Claude Opus 5.5 | 58 pkt | 1. | Trudne analizy i zadania wymagające wielu decyzji. |
| 2. Claude Sonnet 5.5 | 56 pkt | 2. | Codzienna praca, dokumenty i poprawki w kodzie. |
| 3. Gemini 4 Argon | 53 pkt | 6. | Rozmowa oraz analiza tekstu, obrazów, PDF, audio i wideo. |
| 4. GPT-6 Astra | 53 pkt | 3. | Złożone kodowanie, research i obsługa komputera. |
| 5. GPT-6.1 Sol | 52 pkt | 5. | Zadania, przy których trzeba pilnować kosztu API. |
AA: Opus i Sonnet w wariancie Max with fallback, Astra i Sol z Max, Gemini z High. Agent Arena: Max, poza Gemini z High. Miejsce oznacza pozycję w tabeli w chwili odczytu. Na telefonie tabelę można przesunąć w bok.
Źródła wyników: Artificial Analysis oraz Agent Arena. Zakres wejściowych materiałów Gemini: dokumentacja Google.
Na jakich rankingach opieramy porównanie?
Sprawdziliśmy trzy tabele z dwóch organizacji. Artificial Analysis dostarcza zestawienie możliwości i kosztów. Text Arena i Agent Arena należą do tego samego organizatora. Ich wyników nie traktujemy jako trzech niezależnych głosów za danym modelem.
- Artificial Analysis Intelligence Index: porównanie możliwości w zestawie ocen. Korzystamy z bieżącej tabeli modeli, odczytanej 25 października 2026 roku.
- Text Arena, tabela z 22 października: preferencje użytkowników porównujących odpowiedzi. Gemini 4 Argon High zajmuje pierwsze miejsce, z wynikiem 1517 ±7. Opus 5.5 High ma 1509 ±7.
- Agent Arena, tabela z 23 października: ocena pracy agentów, uwzględniająca m.in. realizację zadań, reakcje użytkowników i reagowanie na wskazówki.
To różne miary. Nie dodajemy punktów Intelligence Index do oceny Text Arena. Nie odczytujemy również wyniku „Net Improvement” jako procentu wszystkich rozwiązanych zadań. Tabele pokazują przedziały niepewności, więc niewielka różnica pozycji nie przesądza o przewadze w Twojej firmie.
Liczy się także ustawienie modelu. High, Max i wariant z dopiskiem „with fallback” nie są tą samą konfiguracją. Ranking może się zmienić po nowym pomiarze, aktualizacji albo dodaniu kolejnego modelu. Z tego powodu przy danych podajemy datę i link do źródła.
Zobacz: Text Arena, Agent Arena i Intelligence Index.
Claude, Gemini czy ChatGPT? Różnice w praktyce
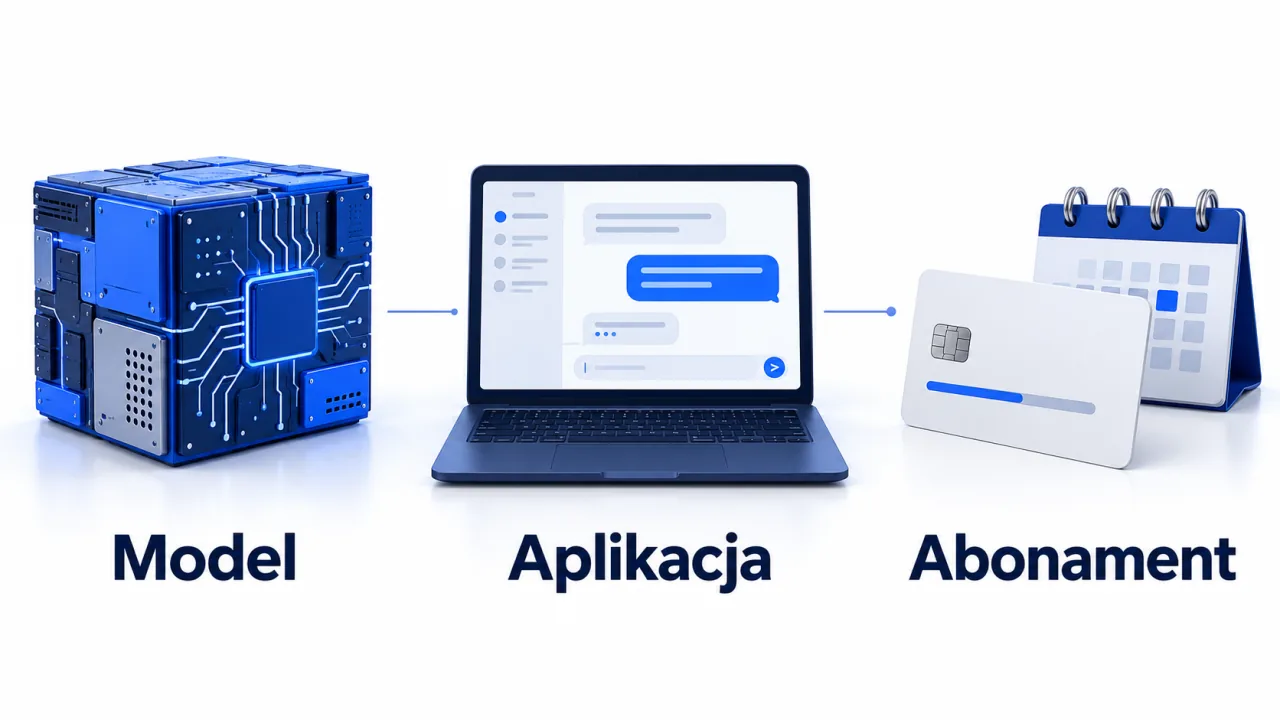
Najpierw rozróżnienie: model to silnik, a aplikacja to miejsce, w którym z niego korzystasz. ChatGPT jest aplikacją OpenAI. GPT-6 Astra i GPT-6.1 Sol to konkretne modele. Podobnie dostępne modele i narzędzia w aplikacji Gemini czy Claude zależą od produktu i planu. Tabela benchmarku nie jest listą funkcji Twojego konta.
Claude Opus 5.5: pierwszy wybór do trudnych zadań
Opus 5.5 prowadzi w przytoczonej tabeli możliwości oraz Agent Arena. Anthropic opisuje go jako model do długiej pracy nad kodem i wiedzą, wymagającej utrzymania kontekstu oraz oceny wielu zależności. To uzasadnia jego pierwsze miejsce w naszym zestawieniu.
Nasza propozycja zastosowania: porównanie kilku ofert, przygotowanie analizy na podstawie obszernej dokumentacji albo plan zmiany w istniejącym systemie. Daj mu materiały źródłowe i poproś o wskazanie informacji, których brakuje do decyzji.
Kiedy wybrać coś lżejszego? Przy krótkiej korekcie maila lub prostym porządkowaniu notatek koszt rozbudowanej analizy może nie przynieść korzyści. Zaczynaj od modelu, który daje wystarczająco dobry wynik. Opis Opus 5.5 u producenta.
Claude Sonnet 5.5: mocny model do regularnej pracy
Sonnet 5.5 jest niżej wycenionym uzupełnieniem Opusa. Producent wskazuje przede wszystkim zadania z jasno określonym zakresem: poprawki błędów, dokumenty, prezentacje i arkusze. To sensowny punkt startu, jeżeli korzystasz z AI często, a nie każde zadanie wymaga najsilniejszego modelu.
Nasza propozycja zastosowania: dopracowanie dokumentu z uwag, przygotowanie materiałów ze znanych danych lub poprawka konkretnego błędu. Przy rozbudowanym problemie z wieloma niewiadomymi porównaj rezultat z Opusem. Zastosowania i ceny Sonnet 5.5.
Gemini 4 Argon: rozmowa i różne formaty materiałów
Pierwsza pozycja w Text Arena jest mocnym sygnałem dla jakości odbieranej przez rozmówców. Nie oznacza jednak, że każda odpowiedź Gemini będzie bardziej poprawna. Preferencja użytkownika i zgodność z faktami to osobne kwestie.
Dokumentacja Gemini 4 Argon wymienia tekst, obraz, wideo, audio i PDF jako wejścia oraz tekst jako wyjście. Model jest więc wart sprawdzenia przy pracy, która łączy różne materiały. Google udostępniło go również użytkownikom planów Pro i Ultra w aplikacji Gemini.
Nasza propozycja zastosowania: przygotowanie podsumowania materiałów do spotkania albo rozmowa o dokumencie i ilustracjach. Przed zakupem sprawdź dostęp do modelu oraz limity na konkretnym koncie. Specyfikacja modelu i informacja Google o dostępności.
GPT-6 Astra: złożone kodowanie i praca z narzędziami
OpenAI pozycjonuje Astrę jako model do najbardziej wymagającej pracy: rozumowania, kodowania, researchu, dokumentów i obsługi komputera. Trzecie miejsce w Agent Arena daje dodatkowy punkt odniesienia dla zadań wykonywanych z narzędziami.
Nasza propozycja zastosowania: zadanie łączące analizę, pracę z plikami i przygotowanie wyniku w określonym formacie. Upewnij się, że używana aplikacja udostępnia potrzebne narzędzia. Same możliwości modelu nie tworzą połączenia z Twoim CRM czy dyskiem. Dokumentacja GPT-6 Astra.
GPT-6.1 Sol: jakość przy niższym koszcie API
Sol jest propozycją OpenAI do złożonej pracy przy niższym koszcie niż Astra. Warto go porównać z droższym modelem na zadaniach, które będą wykonywane wielokrotnie. Nie zakładamy, że wyniki będą identyczne, lecz sprawdzamy, czy różnica ma znaczenie dla odbiorcy.
Nasza propozycja zastosowania: przygotowywanie roboczych odpowiedzi, porządkowanie danych i wykonywanie dobrze opisanego etapu procesu. Jeśli zysk jakości Astry jest niewielki, oszczędność może uzasadniać wybór Sola. Specyfikacja GPT-6.1 Sol.
A co z Kimi, Muse i pozostałymi modelami?
Pięć rekomendacji nie wyczerpuje rynku. Muse Wonder Full ma 56 punktów, Kimi K3.1 Pro 55, a Claude Fable 5.1 w najwyższym przytoczonym wariancie 53 w Intelligence Index. Są więc ważnym punktem porównania, zwłaszcza gdy szukasz alternatywy dla głównych aplikacji.
Nie dopisujemy im ocen za zastosowania, których nie porównaliśmy samodzielnie. Również wynik jednej wersji nie przechodzi automatycznie na inną: Muse Wonder Full i Muse Wonder oraz Kimi K3 i K3.1 Pro to odrębne pozycje. Przy wyborze porównuj dokładne nazwy. Pełna tabela Artificial Analysis pozwala sprawdzić szerszy wybór.
Ile kosztują najlepsze modele AI?
Cena modelu w API nie jest ceną abonamentu aplikacji. API rozlicza użycie, najczęściej przez liczbę tokenów wejścia i wyjścia. Abonament udostępnia określony zestaw modeli, funkcji i limitów. Porównując koszt, najpierw ustal, który sposób dostępu jest Ci potrzebny.
| Model | Wejście | Wyjście |
|---|---|---|
| Claude Opus 5.5 | 4 USD | 20 USD |
| Claude Sonnet 5.5 | 2 USD | 10 USD |
| Gemini 4 Argon | 2 USD | 10 USD |
| GPT-6 Astra | 10 USD | 50 USD |
| GPT-6.1 Sol | 2 USD | 10 USD |
Podstawowe stawki standardowego użycia, bez cache i dodatkowych usług. Długi kontekst, narzędzia oraz tryb rozliczenia mogą zmienić rachunek. Cena Gemini jest promocyjna do 30.11.2026; Google zapowiada później 4 USD za wejście i 20 USD za wyjście.
Cenniki: Anthropic, Google, Astra i Sol.
W praktyce porównuj koszt poprawnie ukończonego zadania. Tańsza odpowiedź nie jest oszczędnością, jeśli później wymaga kilku poprawek. Z kolei droższy model nie musi być opłacalny przy prostym zadaniu. Uwzględnij również czas potrzebny na sprawdzenie rezultatu.
Najlepsze AI do pisania, analizy i kodowania
Zamiast kupować „najlepszy model do wszystkiego”, wybierz narzędzie do zadania. Poniższe propozycje są punktem startu do własnego porównania, a nie odrębnymi wynikami benchmarków.
- Teksty i rozmowa: porównaj Gemini z Sonnetem. Sprawdź, czy zachowują fakty, dopasowują ton i respektują długość tekstu. Wynik Text Arena pomaga wybrać kandydatów, lecz nie zastępuje redakcji.
- Analiza dokumentów: sprawdź Opusa i Gemini. Wymagaj odwołań do materiałów, rozdzielenia faktów od wniosków oraz oznaczenia brakujących danych.
- Kodowanie: porównaj Opusa, Sonnet i Astrę na konkretnym błędzie lub funkcji. Oceniaj uruchomiony program i testy. Przekonujący opis rozwiązania nie dowodzi, że kod działa.
- Powtarzalny proces: zacznij od Sola lub Sonneta i sprawdź koszt całej serii. Gdy rezultat nie spełnia wymagań, porównaj mocniejszy wariant na tych samych danych.
Jeśli dopiero zaczynasz, pomocny będzie poradnik jak wybrać pierwsze zadanie dla AI w firmie. Przy połączeniu AI z konkretnym procesem zobacz wdrożenia AI dla firm albo szkolenia AI dla zespołów.
Jak samodzielnie porównać dwa modele AI?
Weź prawdziwe zadanie, którego wynik potrafisz ocenić. Przygotuj ten sam materiał, polecenie i oczekiwaną formę odpowiedzi dla obu modeli. Określ wcześniej, co będzie błędem: pominięta informacja, dopisana liczba, niedziałający kod czy przekroczona długość.
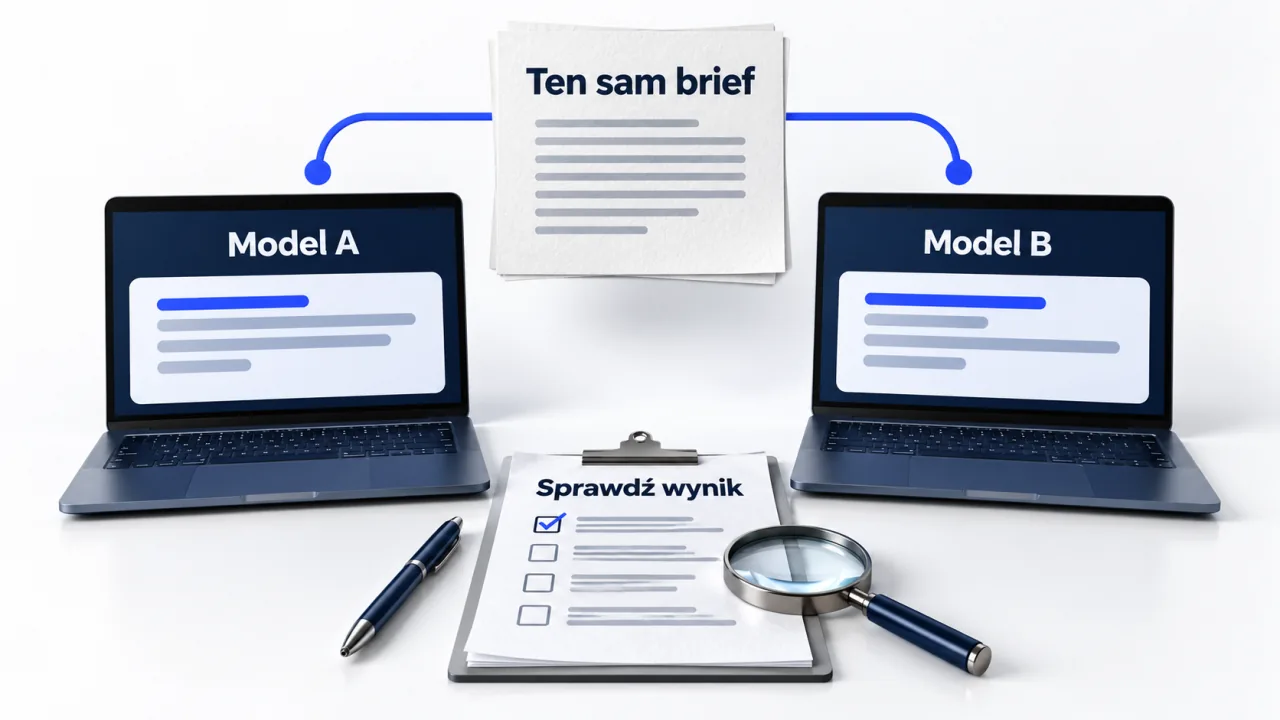
- Podaj identyczne wejście. Nie poprawiaj kontekstu tylko dla jednego modelu.
- Sprawdź rezultat według tych samych kryteriów. Oddziel poprawność od stylu i wygody pracy.
- Zapisz liczbę poprawek, czas i koszt. Uwzględnij własną pracę, a nie tylko rachunek za odpowiedź.
- Powtórz próbę na innym zadaniu tego samego typu. Jedna udana odpowiedź nie opisuje całej jakości modelu.
Przykład do własnego testu: z notatek po spotkaniu przygotuj listę ustaleń, pytań i kolejnych kroków. Model ma zachować nazwiska i terminy oraz nie dopisywać decyzji, których nie ma w źródle. Takie zadanie łatwo sprawdzić bez oceniania odpowiedzi „na wrażenie”.
Więcej o wyborze produktów i warunkach zakupu przeczytasz w poradniku o Kinetyce i kodzie KAMIL10.
Najczęstsze pytania o najlepsze modele AI
Jaki model AI jest teraz najlepszy?
Na podstawie przytoczonych tabel naszym pierwszym wyborem do najtrudniejszej pracy jest Claude Opus 5.5. Gemini 4 Argon prowadzi w Text Arena. Ostateczny wybór zależy od rodzaju zadania, konfiguracji i kosztu.
Claude czy ChatGPT: co wybrać do firmy?
Porównaj konkretne modele i funkcje aplikacji. Opus i Sonnet są kandydatami do analizy, dokumentów i kodu. Astra i Sol do zadań wymagających rozumowania oraz narzędzi, przy różnych kosztach. Najlepszy wybór ustalisz na własnych materiałach.
Czy Gemini jest lepsze od ChatGPT?
Gemini 4 Argon ma lepszą pozycję w przytoczonym Text Arena niż modele GPT z naszej piątki. Astra jest wyżej w Agent Arena. Te wyniki dotyczą innych kryteriów i nie dowodzą przewagi jednej aplikacji w każdej sytuacji.
Dlaczego nie warto zawsze ustawiać Max?
Wyższe ustawienie rozumowania może zmienić czas i koszt odpowiedzi. Przy prostym zadaniu dodatkowa praca modelu nie musi poprawić wyniku na tyle, by uzasadnić wydatek. Porównuj ustawienia na tym samym zadaniu.
Czy ranking obejmuje generowanie obrazów i filmów?
Nie. Porównujemy modele do tekstu, analizy i pracy z narzędziami. Obsługa obrazu lub wideo na wejściu nie oznacza generowania takich materiałów. Do filmów zobacz poradnik pierwszego filmu AI.
Jak działa kod KAMIL10 do Kinetyki?
Wpisz KAMIL10 w polu kodu rabatowego w koszyku. W naszym sprawdzeniu obniżył cenę Gemini o 10%, ze 170 zł do 153 zł. Przed płatnością sprawdź aktualną cenę, rabat oraz warunki produktu.